Jev liefert typisierte Entscheidungen mit kalibrierter Confidence statt generiertem Text – und macht damit den Parser-Code überflüssig.
Jedes produktive AI-System kennt denselben Bruch: Du brauchst eine Entscheidung, auf die dein Code verzweigen kann. Was du bekommst, ist ein String.
Also schreibst du ein zweites Programm. Seine einzige Aufgabe ist es, die Entscheidung wieder aus der Sprache herauszuholen.
Du formulierst "antworte ausschließlich mit gültigem JSON". Du parst. Du
validierst. Du fängst den Fall ab, in dem das Objekt in einem
Markdown-Codeblock steckt. Du versuchst es erneut, wenn das Enum als
"technical support" statt technical zurückkommt. Und du baust einen
Fallback für den Moment, in dem sich das Modell entschuldigt, statt zu
antworten.
Dieses zweite Programm ist kein Detail. In vielen Produktionssystemen ist es ein spürbarer Anteil des Codes – und fast die gesamte Flakiness.
Jev von TypeSafe AI setzt genau dort an. Das Modell gibt keinen Text zurück, sondern typisierte, probabilistische Entscheidungen. Du schickst Zustand und typisierte Fragen, es beantwortet alle in einem einzigen parallelen Durchlauf.
Mitgründer ist Diogo Almeida, der bei OpenAI an den Methoden mitgearbeitet hat, die aus Sprachmodellen instruktionsfolgende Chatmodelle gemacht haben – die Forschung hinter ChatGPT. Danach hat er zwei Jahre im Stealth-Modus an einem Modell gearbeitet, das ausschließlich mit Software spricht.
Seine Begründung ist bemerkenswert nüchtern:
Ich dachte, Chatmodelle führen vielleicht zu AGI. Aber trotz des Hypes wurde mir klar, dass etwas Großes fehlt.
Welches Problem Jev löst
Die meisten Entscheidungen in echter Software sind klein, wiederholt und begrenzt.
Ein paar typische Beispiele:
| Entscheidung | Antwortraum |
|---|---|
| In welche Abteilung gehört dieses Ticket? | 3 bis 10 Optionen |
| Wie dringend ist diese Nachricht? | eine geordnete Skala |
| Ist dieser Kommentar Spam? | ja oder nein |
| Braucht diese Anfrage ein teures Modell? | ja oder nein |
Für all das nutzen Teams heute ein Sprachmodell, das jeden Token einzeln erzeugt – und zahlen dafür Latenz, Preis und Formatrisiko.
Der Antwortraum steht aber längst fest. Er wird nur nirgends deklariert.
Jev dreht die Reihenfolge um:
Du definierst den Antwortraum, bevor du fragst. Deshalb kann das Modell keinen ungültigen Wert produzieren.
Es gibt keine Format-Prompts, weil das Format nicht vom Modell gewählt wird.
Was ein System-One-Modell ist
Der Begriff stammt aus der Zwei-System-Idee der Kognitionspsychologie.
System 2 ist langsames, bewusstes Nachdenken. System 1 ist das schnelle Urteil, das du gefällt hast, bevor du den Satz zu Ende gelesen hast.
Ein System-One-Modell ist entsprechend eine Modellklasse, die schnelle, strukturierte Entscheidungen trifft und typisierte Werte samt kalibrierter Wahrscheinlichkeiten zurückgibt – statt generierten Text.
Der Unterschied ist nicht die Modellgröße, sondern die Architektur:
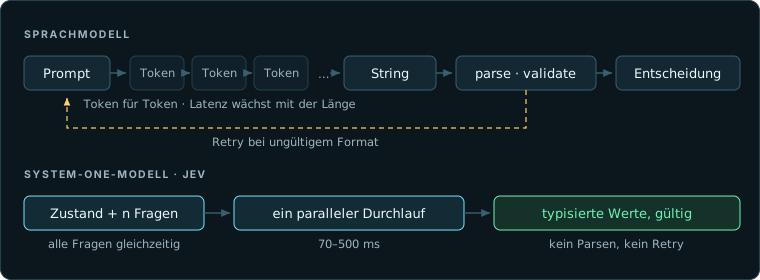
Bei einem LLM hängt die Latenz an der Länge der Ausgabe, und das Ergebnis ist ein String, der alles Mögliche sein kann. Jev nimmt den Zustand und alle Fragen gleichzeitig entgegen und zieht die Antworten aus dem Raum, den du vorher definiert hast.
Der Name ist ein Verweis auf William Stanley Jevons. Sein Paradox besagt: Wenn etwas dramatisch billiger wird, nutzen wir dramatisch mehr davon.
Das ist die eigentliche These hinter dem Produkt. Intelligenz zu einem Zweihundertstel des Preises ist nicht dasselbe Produkt mit Rabatt. Es ist ein anderes Produkt, weil eine ganze Klasse von Entscheidungen automatisierbar wird, die sich vorher schlicht nicht gerechnet hat.
Jev im Vergleich zu einem Frontier-LLM
| Eigenschaft | Frontier-LLM | Jev |
|---|---|---|
| Ausgabe | Text, Token für Token | typisierte Werte, parallel |
| Gültigkeit | muss validiert werden | per Definition gültig |
| Latenz | skaliert mit Ausgabelänge | 70 bis 500 Millisekunden |
| Preis | Input und Output | 0,042 $ pro Mio. Input-Token, Output frei |
| Unsicherheit | ein weiterer selbstbewusster Satz | kalibrierte Wahrscheinlichkeit |
| Stärke | Sprache, Erklärung, Rechnen | begrenzte Entscheidungen |
Die entscheidende Zeile ist nicht der Preis, sondern die vorletzte. Dazu gleich mehr.
Wie man Jev benutzt
Du schickst einen Zustand – das, was beurteilt werden soll – und eine Menge von Fragen. Es gibt genau drei Fragetypen und keine weiteren:
- Choice wählt eine Option aus einer Menge, die du definierst, bis zu 255.
- Score bewertet den Zustand gegen zwei bis zehn geordnete Stufen, die du in Worten beschreibst.
- Noul beantwortet eine Ja-Nein-Frage mit der Wahrscheinlichkeit für Ja.
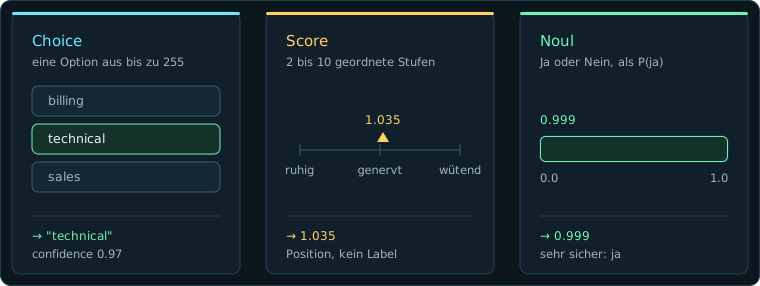
Ein Support-Ticket, das in einem Aufruf triagiert wird:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

ticket = (
    "Hi, I've been trying to connect my Stripe account for 3 days "
    "and it keeps failing. I'm losing sales. Please help ASAP."
)

response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={
                "billing": "Payment or subscription issues",
                "technical": "Bugs or integration problems",
                "sales": "Pricing or account questions",
            },
        ),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=[
                "Calm, just stating facts",
                "Frustrated but civil",
                "Very angry, strong language",
            ],
        ),
        "is_urgent": Noul(
            instructions="The message conveys urgency or time-sensitivity",
        ),
    },
)

print(response.answers["department"].choice)   # "technical"
print(response.answers["frustration"].score)   # 1.035
print(response.answers["is_urgent"].noul)      # 0.999
Drei Urteile, ein Roundtrip, ungefähr 400 Millisekunden. Kein
Prompt-Engineering zum Ausgabeformat. Kein json.loads in einem
try-Block.
Zwei Details lohnen einen zweiten Blick.
Der Frustrations-Score kommt als 1.035 zurück, nicht als 1. Score liefert
eine Position auf deiner Skala, kein Label. Ein Kunde, der knapp über
"frustriert, aber höflich" liegt, wird auch knapp darüber abgebildet. Du
bekommst Auflösung, ohne dir ein Zehn-Punkte-Rubrik ausdenken zu müssen.
Und jede Choice- und Score-Antwort trägt einen Confidence-Wert samt vollständiger Wahrscheinlichkeitsverteilung. Dieses Feld wird am häufigsten übersehen – und ist das Wichtigste an der Antwort.
Ein zweites Beispiel: Paper-Screening
Der Fragetyp ändert sich nicht, wenn die Domäne wechselt. Hier kombiniert mit Valyu, einer Suchplattform für akademische, finanzielle und Life-Sciences-Recherche:
from valyu import Valyu
from typesafe_sdk import Noul, Score, TypeSafeClient

valyu = Valyu()          # liest VALYU_API_KEY
jev = TypeSafeClient()   # liest TYPESAFE_API_KEY

# 1. Retrieval: Primärquellen, gefiltert bevor irgendetwas das Modell sieht.
hits = valyu.search(
    "GLP-1 receptor agonists cardiovascular outcomes",
    included_sources=["valyu/valyu-pubmed", "valyu/valyu-arxiv"],
    start_date="2024-01-01",
    max_num_results=20,
    relevance_threshold=0.5,
)

# 2. Urteil: ein begrenzter Aufruf pro Paper, rund 0,0004 $ pro Stück.
shortlist = []

for paper in hits.results:
    verdict = jev.system_one(
        state={
            "title": paper.title,
            "source": paper.url,
            "content": paper.content,
        },
        questions={
            "is_rct": Noul(
                instructions="This paper reports a randomised controlled trial",
            ),
            "reports_mace": Noul(
                instructions="The paper reports major adverse cardiovascular "
                             "events as an outcome",
            ),
            "evidence_strength": Score(
                instructions="How strong is the causal evidence presented",
                criteria=[
                    "Anecdotal or preclinical",
                    "Observational",
                    "Single randomised trial",
                    "Meta-analysis of randomised trials",
                ],
            ),
        },
    )

    a = verdict.answers
    if a["is_rct"].noul > 0.7 and a["evidence_strength"].score > 1.5:
        shortlist.append((paper, a["evidence_strength"].confidence))
Das Muster ist in beiden Beispielen identisch: ein Zustand, mehrere begrenzte Fragen, eine Antwort, auf der Code direkt verzweigen kann.
Warum kalibrierte Confidence das Systemdesign verändert
Jev gibt eine Antwort zurück und eine Zahl dazu, wie sehr dieser Antwort zu trauen ist. Entscheidend ist: Diese Zahl bedeutet etwas.
TypeSafe trainiert mit einem Verfahren namens Reinforcement Learning for Calibrated Decisions (RLCD).
Der Unterschied zu RLHF ist der Optimierungszielpunkt:
| Verfahren | Optimiert gegen | Typische Folge |
|---|---|---|
| RLHF | menschliche Präferenz | überzeugend klingende Ausgabe |
| RLCD | tatsächliche Ergebnisse | kalibrierte Wahrscheinlichkeiten |
Kalibrierung heißt konkret: Über eine Gruppe von Vorhersagen hinweg sind die mit 0,9 markierten Antworten tatsächlich in etwa neunzig Prozent der Fälle richtig.
Genau diese Eigenschaft macht einen Schwellwert überhaupt erst sinnvoll:
action = response.answers["intent"]

if action.confidence < 0.5:
    # Ehrlich unsicher. Nicht raten.
    route_to_human(user_message)

elif action.choice == "check_balance":
    # Lesend und umkehrbar. Eine niedrige Hürde reicht.
    show_balance(account_id)

elif action.choice == "approve_transfer":
    if action.confidence > 0.85:
        confirm_then_execute(account_id)
    else:
        ask_user_to_confirm(account_id)
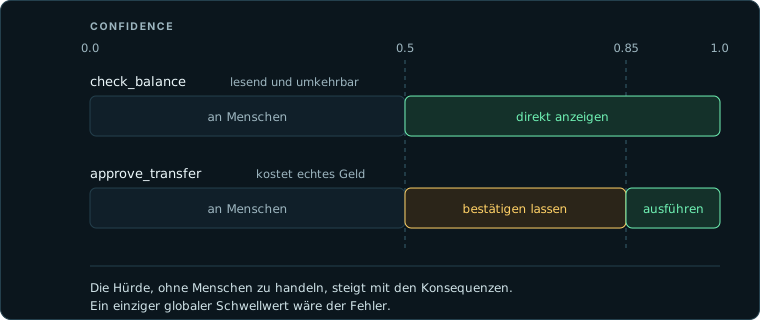
Wichtig ist, was hier fehlt: ein einziger globaler Schwellwert.
Der falsche Screen kostet den Nutzer drei Sekunden. Die falsche Überweisung kostet ihn Geld. Die Hürde, ohne Menschen zu handeln, steigt mit den Konsequenzen eines Fehlers.
Wo diese Hürde liegt, ist eine Produktentscheidung. Mit Jev lebt sie in deinem Code statt in einem Prompt.
Der Einwand gehört dazu, und TypeSafe formuliert ihn selbst: Kalibrierung ist eine Eigenschaft von Gruppen, nicht von Einzelantworten. Eine 0,95 kann falsch sein.
Was du bekommst, ist kein Wahrheitsorakel, sondern ein Regler, der sich im Aggregat vorhersagbar verhält. Das reicht, um darauf zu bauen – und ist deutlich mehr, als ein LLM-Klassifikator liefert, den man nach seiner Sicherheit fragt und der mit einem weiteren selbstbewussten Satz antwortet.
Wann Jev sinnvoll ist – und wann nicht
Jev konkurriert nicht mit Opus 5 oder GPT-5.6.
Es konkurriert mit dem Klassifikator, den du aus einem billigen LLM und vierhundert Zeilen Parsing gebaut hast – und mit den Entscheidungen, die du nie automatisiert hast, weil sich die Rechnung nicht gelohnt hat.
Gute Passung:
- Der Antwortraum ist begrenzt und vorab bekannt.
- Volumen oder Latenz sind die eigentliche Einschränkung.
- Du brauchst eine kalibrierte Confidence, um eine Aktion freizugeben.
- Dieselbe Entscheidung fällt tausend- oder millionenfach.
- Mehrere Urteile gehören zum selben Zustand.
Schlechte Passung:
- Du brauchst Worte: Zusammenfassungen, Antworten, Erklärungen.
- Du brauchst Rechnen oder mehrstufiges Schließen.
- Der Antwortraum ist offen oder wird erst zur Laufzeit entdeckt.
- Die Begründung ist wichtiger als die Entscheidung.
- Es ist ein Einzelfall, kein wiederkehrendes Muster.
Der häufigste Fehler wäre, daraus ein "one size fits all" zu machen. Ein System-One-Modell ersetzt kein System 2. Es entlastet es.
Die Architektur, die sich rechnet: die Kaskade
Setzt man beides zusammen, ist die interessante Architektur nicht "ersetze dein LLM", sondern eine Kaskade – mit Jev als schneller, billiger, kalibrierter Eingangstür, die entscheidet, was als Nächstes passiert.
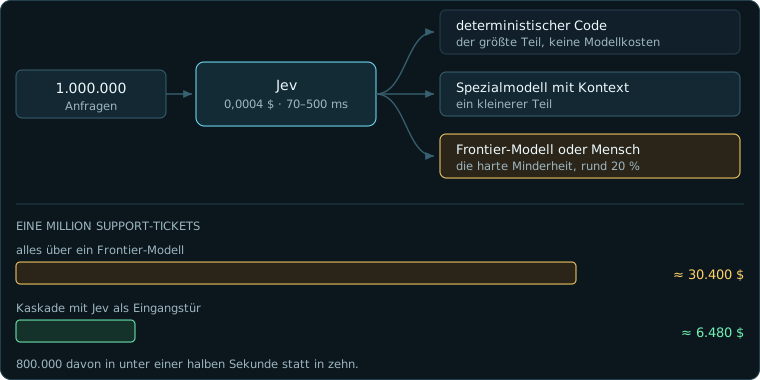
Die meisten Anfragen erledigt gewöhnlicher Code, weil Jev sie in etwas Deterministisches einsortiert hat. Ein Teil geht an ein Spezialmodell mit passend geladenem Kontext. Der Rest – die wirklich schwierigen und wirklich teuren Fälle – geht an ein Frontier-Modell oder an einen Menschen.
Die Rechnung auf eine Million Support-Tickets ist wenig subtil:
| Ansatz | Rechnung | Kosten |
|---|---|---|
| Alles durch ein Frontier-Modell | 1 Mio. × ~0,0304 $ | ~30.400 $ |
| Kaskade | 1 Mio. × 0,0004 $ + 20 % × 0,0304 $ | ~6.480 $ |
Das Geld ist dabei die weniger interessante Hälfte.
Achthunderttausend dieser Tickets werden jetzt in unter einer halben Sekunde beantwortet statt in zehn. Die Ersparnis, die Nutzer tatsächlich bemerken, ist nicht der Rechnungsbetrag. Es ist, dass das System sofort reagiert.
Und der Regler, der die Aufteilung bestimmt, ist der Confidence-Schwellwert. Er liegt in deinem Code, er ist umkehrbar, und du kannst ihn daran messen, ob sich deine Eskalationen im Nachhinein als berechtigt erwiesen haben.
Du tunst das System, ohne das Modell anzufassen.
Was offen bleibt
Ein neues Modell mit einer neuen Kategorie bringt auch neue offene Fragen.
Vendor-Abhängigkeit
Der Antwortraum liegt zwar in deinem Code, das Urteil aber bei einem einzelnen Anbieter. Für eine Komponente, die als Eingangstür vor allem anderen sitzt, ist das eine ernsthafte Abhängigkeit. Ein Fallback-Pfad auf einen LLM-Klassifikator bleibt sinnvoll.
Kalibrierung ist kein Freibrief
Kalibrierung gilt im Aggregat und für die Verteilung, auf der trainiert wurde. Verschiebt sich deine Datenverteilung, verschiebt sich auch die Verlässlichkeit der Zahlen. Wer Schwellwerte setzt, sollte Eskalationen protokollieren und regelmäßig gegen die tatsächlichen Ergebnisse prüfen.
Kriterien sind der neue Prompt
Das Format kann nicht mehr kaputtgehen, die Beschreibung der Optionen schon. Schlecht abgegrenzte Choice-Kriterien oder unscharfe Score-Stufen erzeugen weiterhin schlechte Urteile – nur eben in gültiger Form. Die Arbeit verschwindet nicht, sie verschiebt sich vom Format zur Definition.
Keine Begründung
Du bekommst eine Entscheidung und eine Wahrscheinlichkeit, aber keinen Grund. Für Audits, Compliance-Fälle oder Nutzer, denen man eine Ablehnung erklären muss, braucht es weiterhin ein Modell, das Sprache produziert.
Warum das größer ist, als es aussieht
Fast jedes Frontier-Lab arbeitet gerade daran, System 2 besser zu machen: längeres Denken, mehr Schritte, tieferes Schließen.
Gleichzeitig sind die meisten Entscheidungen in echter Software System 1 – und wir bezahlen dafür seit Jahren System-2-Preise, in Geld und in Latenz.
Der eigentliche Beitrag von Jev ist deshalb kein Benchmark. Es ist eine Grenzziehung:
Sprache dorthin, wo Sprache gebraucht wird. Entscheidungen dorthin, wo Code verzweigt.
Das hat spürbare Folgen für die Architektur:
- Der Parser-Code verschwindet, weil es nichts mehr zu parsen gibt.
- Retry-Logik für Formatfehler wird gegenstandslos.
- Unsicherheit wird ein Wert im Code statt ein Bauchgefühl im Prompt.
- Schwellwerte werden zu Produktentscheidungen, die man messen kann.
- Entscheidungen, die sich nie gerechnet haben, werden automatisierbar.
Der letzte Punkt ist der, auf den der Name anspielt. Wenn ein Urteil vier Zehntausendstel Dollar kostet und in einer halben Sekunde da ist, stellt man plötzlich Fragen, die man vorher gar nicht gestellt hätte: zu jedem Log, jedem Commit, jeder eingehenden Nachricht.
Ob Jev dieses Versprechen einlöst, wird sich erst in Produktionssystemen zeigen. Die Kategorie dahinter ist aber unabhängig vom einzelnen Anbieter überzeugend – und sie schließt genau die Lücke, die jedes AI-System heute mit eigenem Parser-Code überbrückt.
Basierend auf dem Launch von Jev durch TypeSafe AI, Aussagen von Mitgründer Diogo Almeida sowie den veröffentlichten SDK-Beispielen. Preis-, Latenz- und Kostenangaben stammen aus den Angaben des Anbieters.